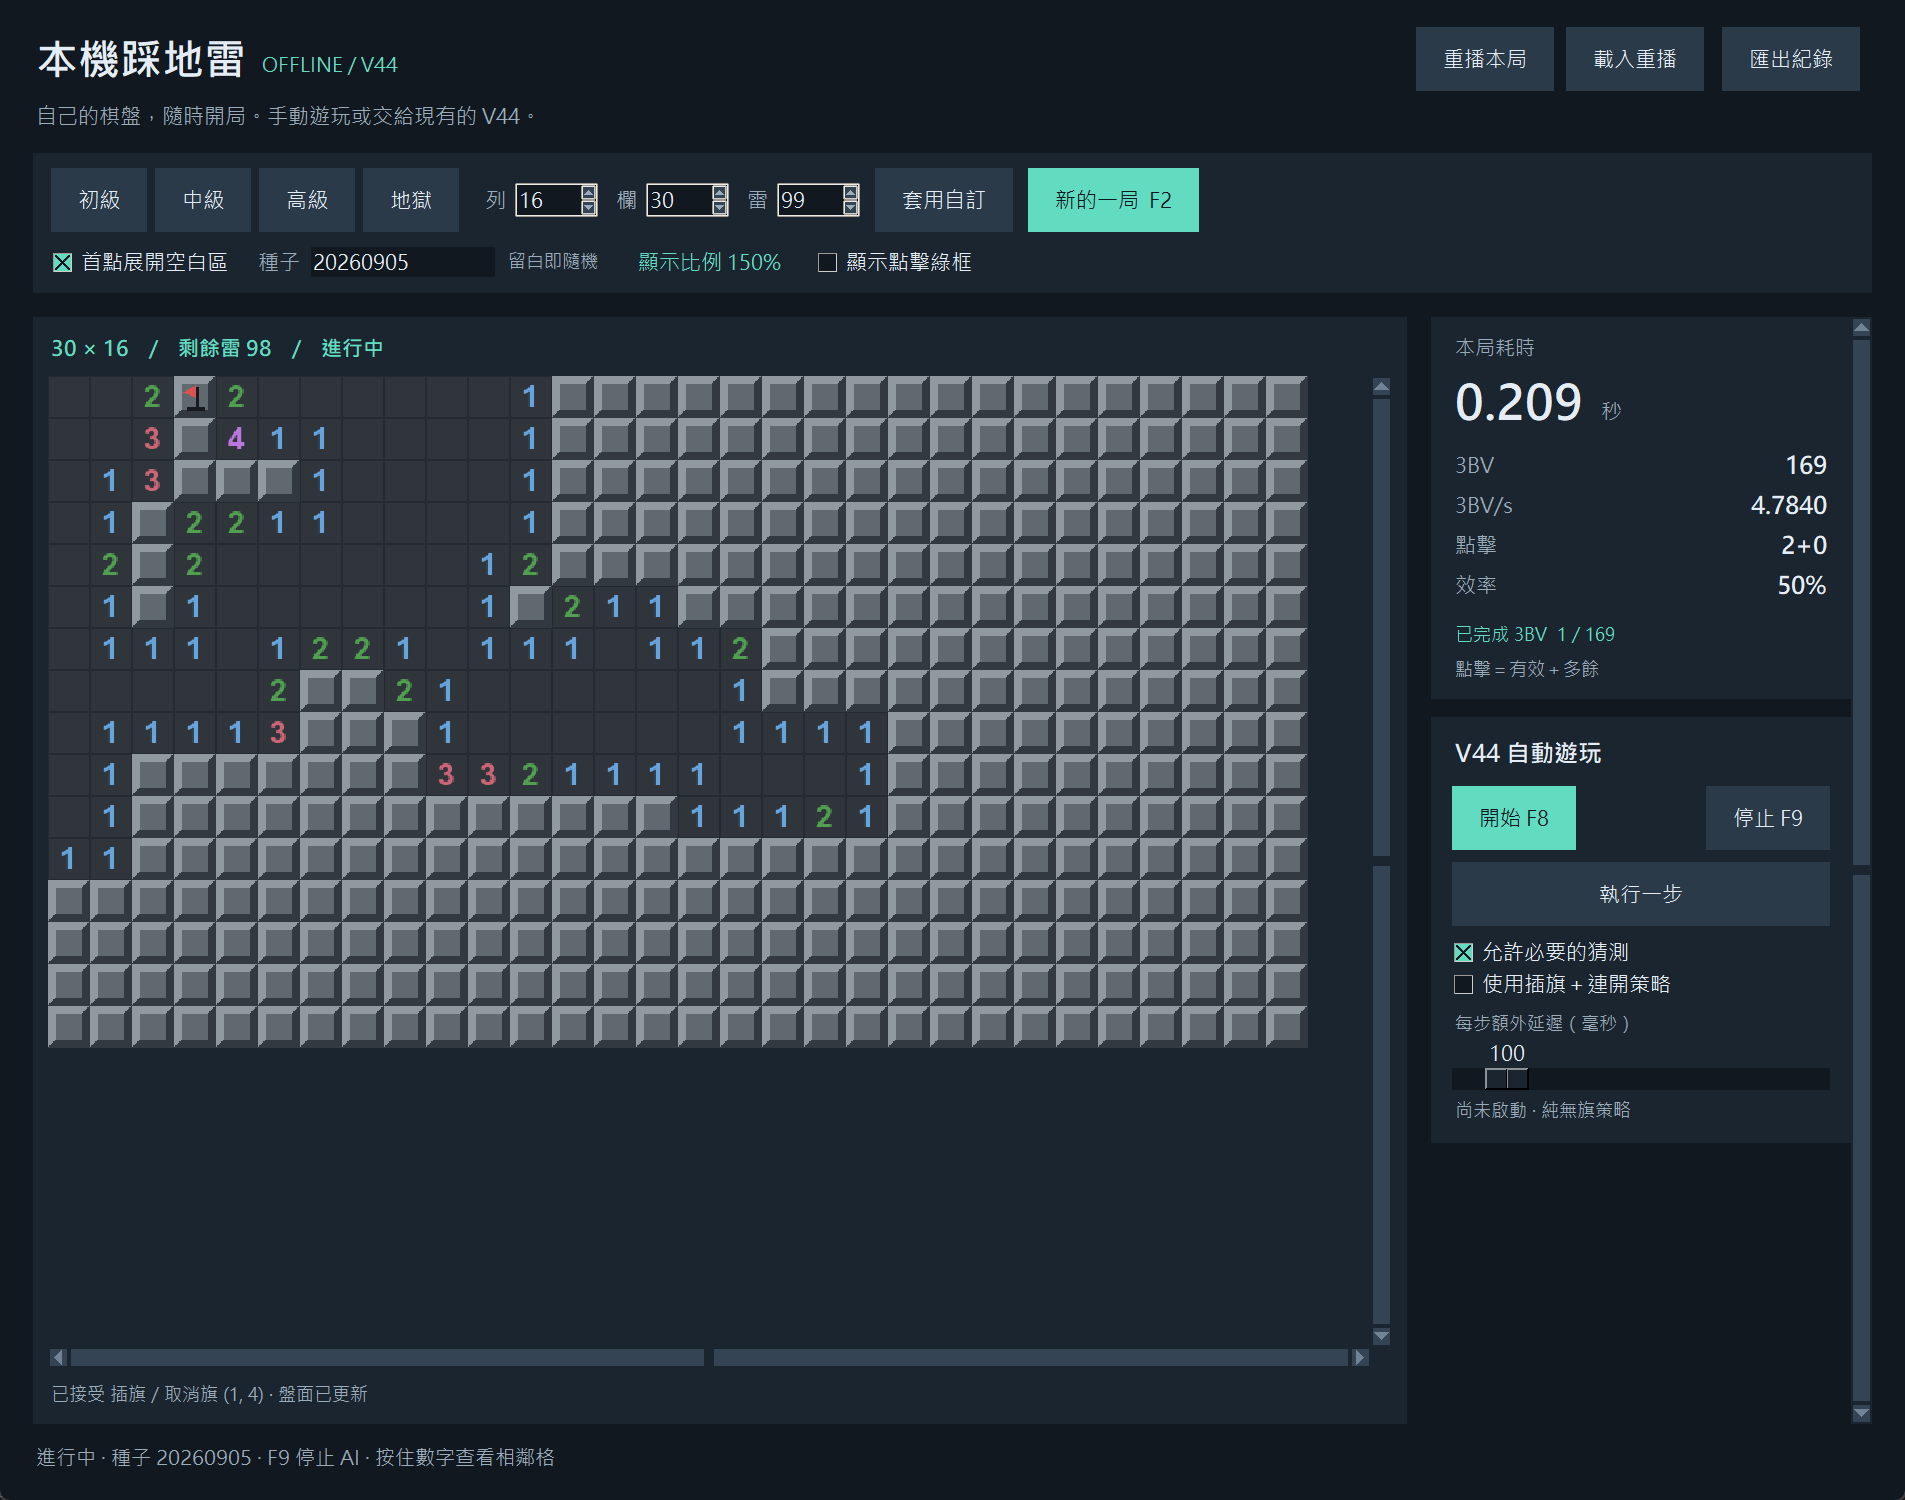
Minesweeper AI 是我用 Python、PyTorch 與 Tkinter 製作的開源踩地雷專案,提供可直接執行的 Windows 桌面程式。 你可以手動玩、按 F8 交給 V44 自動解盤,或在對局後重播棋盤,查看每一步落子前的踩雷機率。遊玩與分析都在本機執行。
這頁集中提供下載、啟動方式與開發細節。如果你想先了解數字推理、神經網路與勝率的關係,可以先讀 踩地雷 AI 原理與勝率實測。
Windows 下載與啟動:不用另外安裝 Python
- 開啟 Minesweeper AI v0.1.0 下載頁,在 Assets 選擇
MinesweeperAI-v0.1.0-windows-x64.zip。 - 完整解壓縮,保留
MinesweeperAI.exe旁的_internal資料夾,不要只搬移 exe。 - 雙擊
MinesweeperAI.exe,可直接手動遊玩;F8 開始 AI,F9 或 Esc 停止 AI,F2 開新局。
| 下載前想知道的事 | 目前公開版 |
|---|---|
| 作業系統 | Windows x64;未提供 macOS/Linux 成品 |
| 介面 | 繁體中文,固定 150% 顯示比例 |
| AI 執行方式 | 內附 CPU 版 PyTorch 與 V44 模型,不需要 NVIDIA 顯示卡 |
| 帳號與連線 | 遊玩、AI 與重播分析不需要帳號、API Key 或雲端 AI 服務 |
| 原始碼 | Python 原始碼與 MIT 授權說明;第三方元件另依 NOTICE |
這是公開測試版,操作方式與環境限制以 專案 README 為準;想從原始碼執行的人,可接著閱讀下方架構與文末的研究入口。
Minesweeper AI is an open-source Python project with a Windows x64 desktop app, a constraint-based solver, selective neural inference, and replay analysis. It runs locally on CPU without an API key. The app interface is Traditional Chinese; see the English README for download and setup instructions.
為什麼把求解器做成可重播的決策系統?
這個專案最初已經有透過畫面辨識與滑鼠操作來玩踩地雷的工具,後續累積了求解器、模型與實驗流程。當我想比較版本、檢查一次猜測,或確認人工操作與 AI 接手後的行為,單看一局最後贏或輸就不夠了。
我需要一個能固定棋盤條件、保存完整行為,並回到落子前重新檢查的環境。這是後來加入本機遊戲與重播分析的原因:讓決策、操作與評估可以放在同一套流程裡。
它現在能做什麼?
目前的公開版本把四個部分放在一起:
- 遊戲環境:四種難度與自訂盤面,支援首點保護、插旗、連開、手動與 AI 接續操作。
- V44 混合代理:先做約束推論,再於符合條件的非精確局面使用神經風險估計與結果策略。
- 重播與單步分析:回到歷史棋盤,檢查已發生動作的落子前雷率,以及操作後的實際效果;目前不能改點另一格並試走後續。
- 離線實驗工具:保存完整勝敗局,收集反事實分支,再以配對棋盤比較候選部署。
Windows 發行包已包含 CPU 版 PyTorch 與模型;遊玩和分析不用呼叫雲端服務。原始碼也保留桌面觀察器,可沿用既有的深色棋盤辨識方式。
先對照 minesweeper.online 的開局方式
一般模式由玩家自己選第一格,第一步可能只揭露一個數字,也可能展開空白區。NG 無猜模式則有綠色 X 指定起點。這是介面上最容易注意到的差異。
還要再看指定首點之後的保證:官方規則 說明,從綠色 X 開始,整盤可以在不猜雷的前提下完成。因此,NG 不只是指定第一格,或要求第一次 reveal > 1;它也要求後續有不靠猜測的解法。
在本專案裡,要分開看以下三個設定:
| 設定 | 具體保證 |
|---|---|
| 首點安全 | 第一格不是雷;可能只開出一個數字 |
| 首點展開空白區 | 第一格為 0,會連帶打開周圍的安全格 |
| 無猜棋盤 | 從指定起點開始,後面也能一直靠邏輯解完 |
目前 GUI 只有前兩種首點設定,沒有無猜盤生成器。 即使第一步打開很多格,後面也可能要猜。後文的本機 5,000 張測試盤,是這種「首點展開空白區的隨機盤」,不能把它叫作 NG 測試。
另外,關閉「允許猜測」只會讓 AI 找不到可證安全動作時停下,不會更換棋盤。後文的「無猜路徑」是這個禁止猜測的求解流程;1,696 筆 NG 測試則使用另外匯入的既有無猜盤與指定首點。「無旗(NF)」只是操作時不插旗,和棋盤是不是 NG 無關。
Python 求解器原理:優先採用可證明的答案
V44 的核心不是直接把棋盤丟進神經網路,讓它輸出下一格。solver.py 先建立局部約束、做子集合推論,將前沿拆成連通分量枚舉,再考慮全域剩餘雷數。
標準遊玩會把分量枚舉上限從 24 自適應提高到 40;無猜路徑則是 40 到 64。增加枚舉能力的目的,是讓更多局面能以可驗證的推論處理,代價則是計算量與等待時間。
決策的優先順序是:
- 有可證安全的動作,先執行安全動作。
- 沒有安全動作,但取得精確機率,沿用精確推論的選擇流程。
- 只有在沒有安全動作、推論又是非精確結果時,才允許神經估計介入。
部署中,學到的風險會與求解器的估計結合;符合門檻的大盤局面,也可能讓 top-three outcome policy 影響候選落點。這個策略的適用範圍有限,不代表所有猜測都由結果模型接管。
V44 是部署設定,使用的是 V40 calibrated-abstention checkpoint。 模型權重、推理上限與策略門檻是不同層次的變更,因此單靠版本號不能判斷是否重新訓練。
第二個取捨:GUI 與觀察器共用決策引擎
本機模擬器知道隱藏雷位,這是管理遊戲所需的狀態;代理則只應取得公開盤面與總雷數。兩者共用程式環境,不代表可以共用所有資訊。
LiveDecisionEngine 放在 desktop_live.py,供本機 GUI 與桌面觀察器共用。模擬器的雷位與種子不傳進這個引擎,學習策略做出的合法選擇也要能穿過轉接層,不能被轉接層重新排序而悄悄失效。
| 模組 | 負責的事 |
|---|---|
game.py | 延後到首個開格時布雷、公開觀測、展開、旗子、連開與終局 |
solver.py | 約束推論、分量枚舉與剩餘雷數整合 |
replay_inference.py、replay_deployment.py | 模型推論與部署載入 |
desktop_live.py | GUI 與桌面觀察器共用的決策引擎 |
local_game.py、local_app.py | 動作紀錄、Tk 介面與互動 |
local_replay.py、replay_analysis.py | 歷史棋盤重建與單步風險分析 |
推論在 UI 執行緒之外執行,結果回來時還要檢查棋盤是否已改變。玩家換局、手動點格或切換重播後,舊狀態算出的動作不能再套用。這個檢查對「手動玩到一半交給 AI」尤其重要。
第三個取捨:重播不能只把動作重新點一遍
重播要能向前、向後跳,也不能把正在玩的原始對局一起改掉。實作上以稀疏的盤面變更搭配週期性 checkpoint 重建歷史狀態,讓時間軸顯示和原始對局的動作、統計分開。
終局揭露全部雷位只是顯示行為。分析某一步時,輸入仍是那一步之前的公開觀測,不是結束後已經看見答案的棋盤。
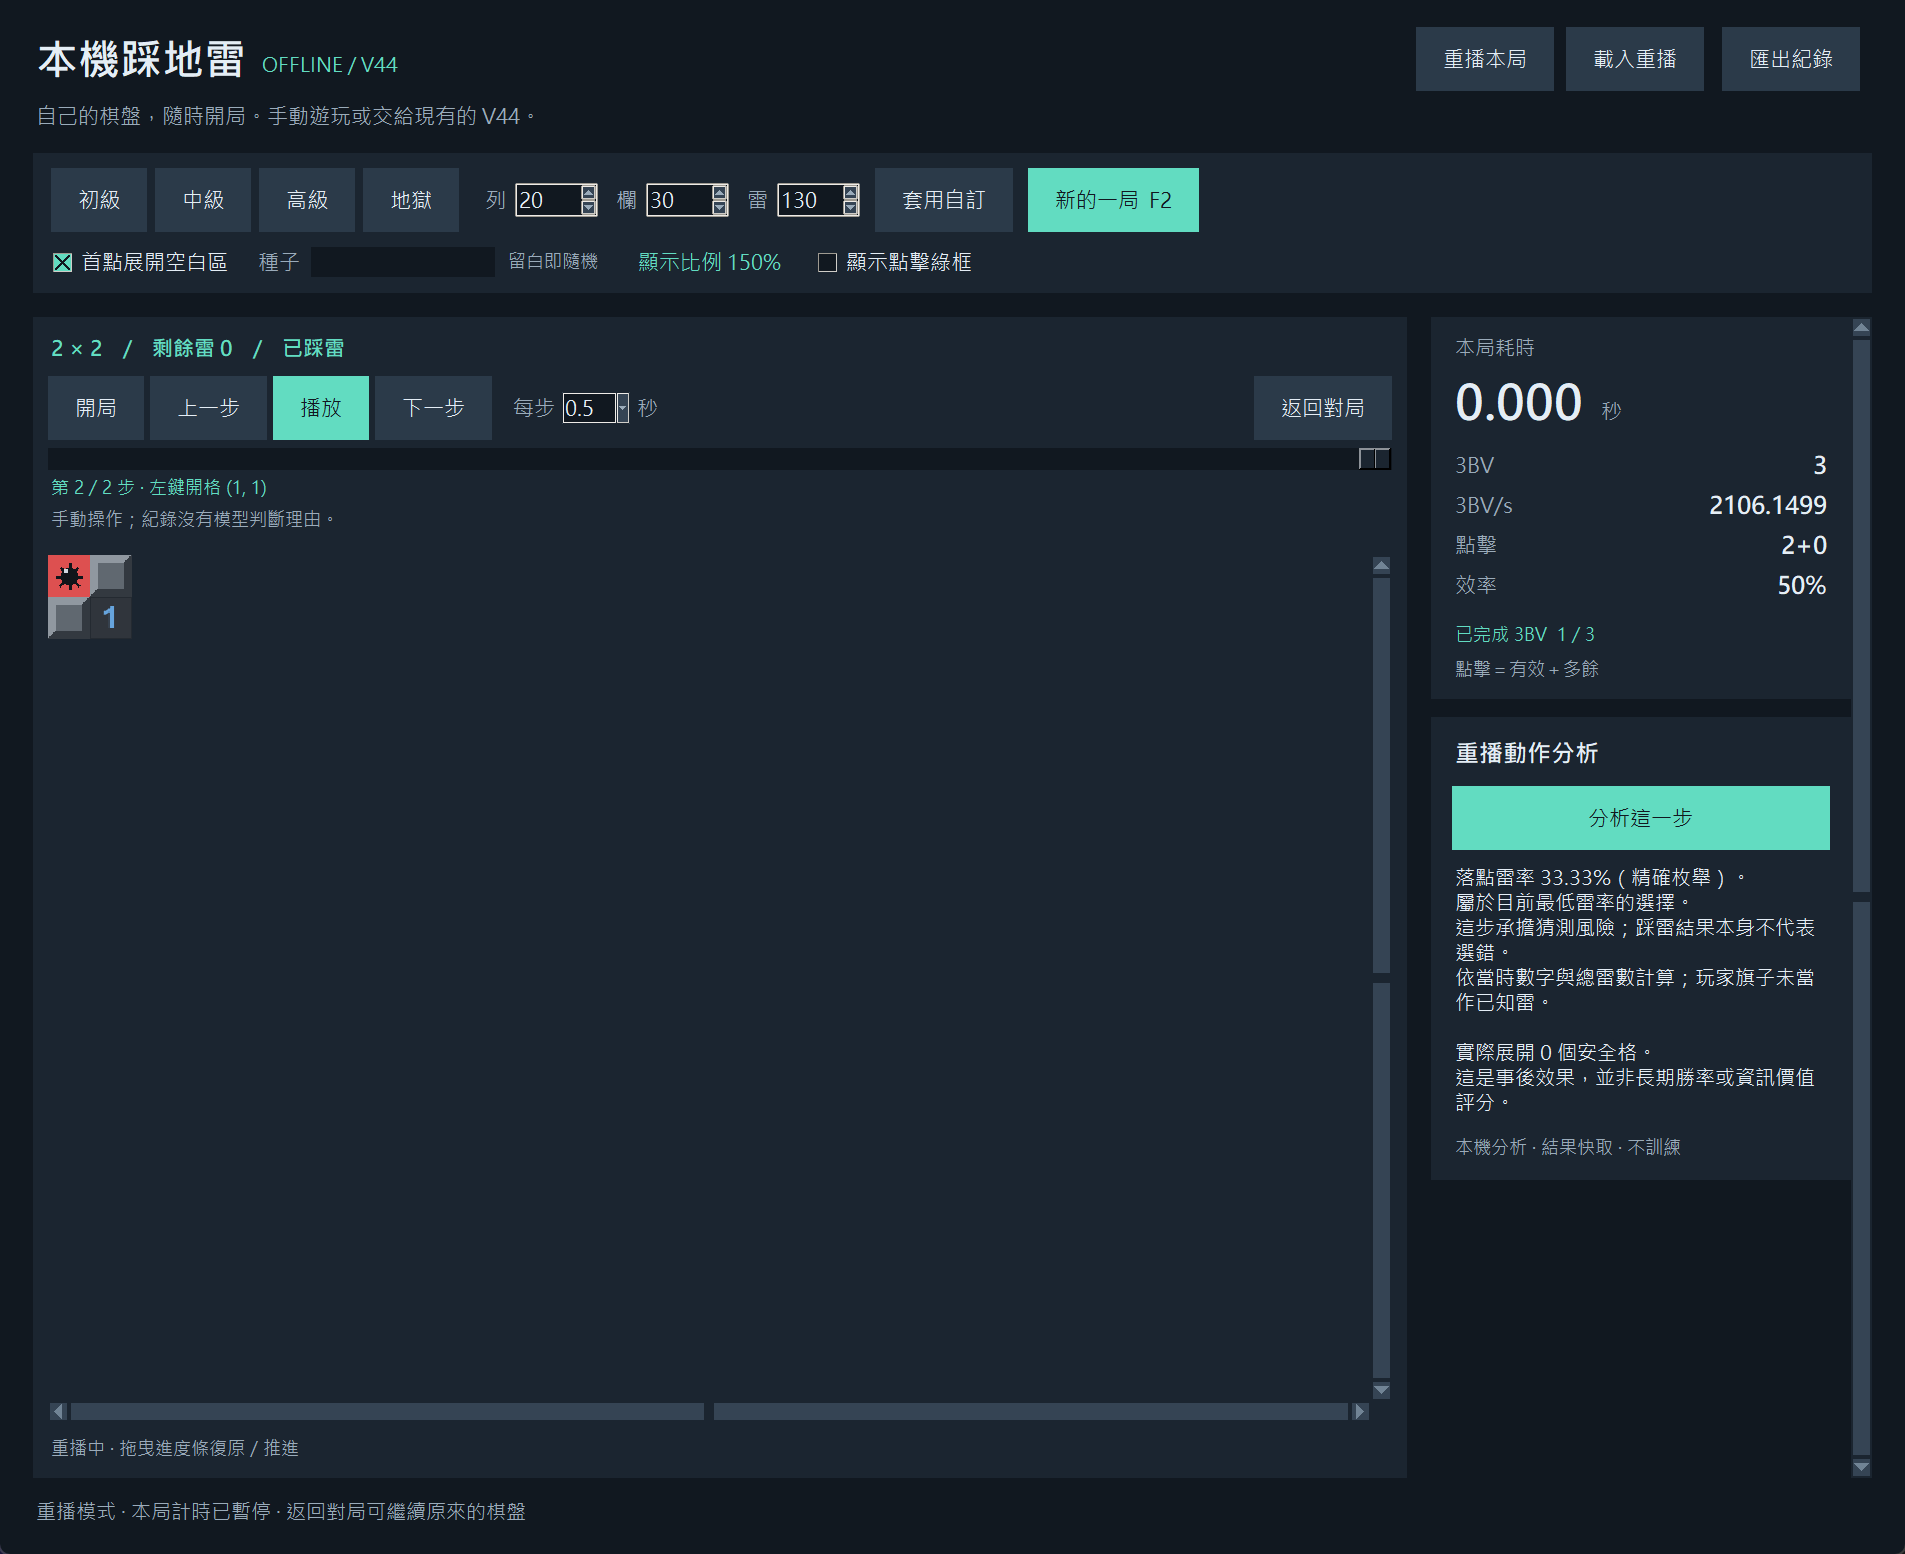
這裡有三個容易誤導人的地方,需要刻意處理:
- 旗子不是已知真值。 分析時先把玩家的旗子還原成未知格,避免錯旗污染約束,產生虛假的「必定安全」。
- 邊際雷率不等於連開的聯合風險。 不能將其中一格的機率,直接當成整次連開至少踩一顆雷的機率。
- 觀察到的效果不等於預期收益。 這步展開了幾格,是事後觀察;沒有額外估計,就不能宣稱它讓整局勝率提高多少。
分析採按需計算,一次只有一個待處理評估,結果在同一份重播內快取。換到另一份重播時,舊請求的結果會被丟棄。
我怎麼確認微調後的模型有沒有更會贏?
這次要改良的是「需要模型協助時,怎麼挑下一格」。我保留原本的求解器、雷率預測和其他模型部分,只微調負責開格選擇的部分,做出一個測試版本。下文把目前使用的 V44 稱為原版,把微調後的版本稱為候選。
先收集可以比較選擇的局面
local_selfplay.py 使用與 GUI 相同的決策引擎,先玩高級、地獄各 1,000 局,合計 2,000 局,結果是 870 勝、1,130 敗。這批設定是首點展開空白區、不插旗,贏的和輸的都保存。
接著,在部分需要模型協助的局面,複製三份相同的遊戲狀態,分別點 A、B、C 三個候選格,再讓原版 AI 各自玩到結束。假設點 A 的分支輸了、點 B 的分支贏了,這次模擬就提供了比較兩個選擇的資料。這種「同一局面改走另一個動作」的比較,也叫反事實分支。
最後取得 194 個這樣的局面,其中 34 個出現不同候選落點帶來不同勝敗。其他局面可能三個分支都贏或都輸,仍保留用來學習結果預測,但較難告訴模型哪個選擇比較好。2,000 局遊戲,不等於 2,000 個能教它選對落點的例子。
模擬器用真實雷位執行遊戲,模型收到的輸入仍只有當時已揭露的數字與總雷數。這是額外的資料收集工具,重播介面目前不能直接這樣試走。
再分開「預測準不準」與「選得好不好」
資料按棋盤分組,158 個局面用來訓練,另外 36 個留著檢查訓練結果,同一棋盤不會同時進兩邊。
檢查時有兩個問題:
- 預測準不準? 模型對各落點的勝敗預測,和實際模擬結果有多接近。
- 選得好不好? 讓它真的挑一個落點,選中的分支最後有沒有贏。
候選的預測誤差有變小,但在那 36 個保留局面裡,選中獲勝分支的數量仍然是 13 個,和微調前一樣。因此,不能只看到誤差降低,就說它更會選。
預測誤差的數值怎麼看?
這裡用 Brier 分數衡量預測與 0/1 勝敗結果的誤差,越低越好。它從約 0.2581 降到 0.2532;這是誤差分數,不是 25.32% 的勝率。單一分支的勝敗也只是一次模擬結果,不是該落點已知的真正長期勝率。
最後讓兩個版本玩同樣的新棋盤
我另外準備了高級、地獄各 2,500 張新棋盤,合計 5,000 張。每張棋盤讓原版與候選各玩一次,第一步規則、是否插旗和其餘設定相同。這就是「配對測試」:比較同一題上的表現,而不是讓兩個版本各抽一批不同難度的題目。
| 版本 | 贏了幾局 | 勝率 |
|---|---|---|
| 原版 V44 | 2,189/5,000 | 43.78% |
| 微調後的候選 | 2,191/5,000 | 43.82% |
候選只多贏兩局,還不足以確認它比較強,所以沒有替換原版。 其中有 8 張棋盤只有候選贏、6 張只有原版贏;剩下的棋盤兩者同勝或同敗,不能把多出兩勝理解成只改變了兩局的結果。
為什麼多贏兩局還不夠?
用來比較配對勝敗的精確 McNemar 檢定,得到 p = 0.790527。它檢查的是「只有候選贏」和「只有原版贏」的差異是否夠明確;8 對 6 的差距沒有提供足夠證據支持候選更好。這也不是在證明神經模型沒用,因為兩個版本都使用模型。
這 5,000 張棋盤沒有拿來訓練或調整參數,逐局結果已保存。之後重跑它們可以核對結果,但若拿這些棋盤來改模型,就不能再把同一批當成沒看過的新考題。
V44 到底贏了多少?三次測試的結果
前面出現了 6,000、5,000 和 1,696 三個數字。它們是三次不同測試的棋盤數量,沒有合併成一個「V44 的總勝率」。
第一次:V44 有沒有比更早的 V32 好?
兩個版本各玩相同的 6,000 張棋盤,初級、中級、高級各 2,000 張。這次第一格只保證安全,不保證開出空白區。
| 難度 | 舊版 V32 | V44 |
|---|---|---|
| 初級 | 83.45% | 83.40% |
| 中級 | 68.55% | 69.40% |
| 高級 | 32.85% | 34.50% |
這份歷史報告裡,V44 的中級、高級勝率有提高,初級少贏一局。它比較的是 V32 → V44 的整套決策改動,不能把增加的勝局全部算成神經模型的功勞。
第二次:在 V44 上再微調模型,有沒有更好?
這就是上一節的 5,000 張新棋盤,高級與地獄各 2,500 張。這次首點保證展開空白區,並且不插旗。
原版 V44 贏 2,189 局,微調候選贏 2,191 局。只多贏兩局,沒有足夠證據支持換版,所以目前仍使用 V44。
這兩次測試的數字不能直接接著看。舉例來說,同樣叫 V44:
- 在第一次測試的高級盤,勝率是 34.50%。
- 在第二次測試的高級盤,勝率是 50.12%。
這不代表中間又把模型練強了;兩次的開局規則、操作方式和測試棋盤都不同。第二次一開始就保證開出空白區,測試條件已經改變。這些結果也無法單獨算出「只改首點」究竟提升了多少勝率。
所以要判斷一次改動有沒有用,應比較同一次測試裡的兩個版本。上面的 43.78% 則是第二次高級與地獄合併的成績,不是高級單一難度的勝率。
第三次:V44 能不能解完這批無猜盤?
這次不比新舊版本,而是讓 V44 從指定起點,解另外匯入的 1,696 筆 NG 棋盤,結果全部解出。
它表示「這批已有無猜解法的棋盤,V44 都找出了安全解法」。這批資料原本還是已獲勝的重播,不能拿這個 100%,去代表前面一般隨機盤需要猜時的勝率,也不能保證其他所有 NG 棋盤都能解出。
哪些測試資料還能核對?
第二次 5,000 張測試保留了完整逐局結果。第一次 6,000 張目前有歷史報告,但缺少完整逐局原始資料與當時完全相同的求解器版本,因此無法完整重現當時那次執行。上表的歷史數值來自保留的報告,詳細來源列在研究論文與重現說明中。
打包成可用的程式,也保留研究入口
Windows v0.1.0 使用 PyInstaller 打包 Python、CPU PyTorch 與 V44 權重。使用者完整解壓縮後可直接執行;_internal 是程式的一部分,必須與 exe 一起保留。
GUI 目前為繁體中文、固定 150% 顯示比例,大盤面用捲動處理。完成的對局記錄放在 %LOCALAPPDATA%\MinesweeperAI\local-feedback,不會自動上傳,也不會觸發訓練。
記錄、訓練與部署更新是三個分開的步驟。 保留一局不代表把那局每個動作都當成正確示範;候選訓練完成,也不代表應該自動替換使用中的版本。
原始碼採 MIT 授權,第三方元件與資料範圍另列在 NOTICE。下載版是公開測試版;實際操作與環境限制以發行頁和 README 為準。
下載與使用常見問題
這是網頁版踩地雷,還是需要下載的程式?
這份公開版本是 Windows 桌面程式,需要下載並解壓縮後執行。本文展示的棋盤與重播是程式畫面,這個網站頁面本身不能直接遊玩。
AI 可以保證不踩雷,或每局都贏嗎?
不能。一般隨機盤面可能需要猜測;關閉「允許猜測」後,AI 找不到可證安全的動作就會停下,也不會把盤面變成無猜盤。各批勝率的規則與限制列在前面的實驗紀錄。
為什麼只複製 exe 後打不開?
_internal 裡有執行環境與模型所需檔案,必須與 MinesweeperAI.exe 一起保留。請先重新完整解壓縮;仍有問題時,參考 README 的啟動問題說明 與 Issues。
接著可以看哪些實作?
後續最有價值的改進,仍是增加能區分選擇優劣的資料、維持推論與介面的一致性,並在固定規則下驗證收益。介面讓這些問題看得見,評估流程則決定哪些改動值得留下。